6.5 End-to-End Pick & Place 배포
6.5.1 배포 전 고정해야 할 계약
- 정책 체크포인트 해시와 학습 데이터 버전
- base model/adapter/dataset exact revision과 train episode ID
- train-only normalization stats/hash (
meta/stats.json전역 통계와 구분) - 카메라 serial, 해상도, FPS, exposure, mount
- 관절 이름, 순서, 단위, 캘리브레이션 ID
- camera
rename_map, action representation, inverse-normalization 계약 - 언어 prompt grammar
- action chunk 크기, 실행 주기, temporal ensemble 파라미터
- workspace/joint/rate limit
- reset pose와 에피소드 성공/실패 정의
LeRobot의 실물 로봇 튜토리얼은 시연 기록, 데이터 시각화, 정책 학습, 평가의 전체 흐름을 제공한다. 최신 CLI는 변경될 수 있으므로 공식 문서를 기준으로 명령을 기록한다.[Hugging Face LeRobot]
최신 배포에서는 local RTC와 remote inference를 구분한다. local RTC는 rollout process의 background thread에서 동작하고, remote backend는 별 process/host의 policy server와 통신한다. execution_horizon, max_observation_age_s, action/startup timeout, starvation grace를 실측 지연과 chunk horizon에 맞춰 설정한다. buffer exhaustion이나 freshness 위반은 무기한 마지막 명령 유지가 아니라 HOLD/FAULT로 연결한다. task 변경 시 이전 instruction의 queue와 in-flight 결과를 폐기한다.[Hugging Face Policy Deployment/RTC]
6.5.2 권장 실행 순서
- 녹화 영상과 관절 로그를 재생하는 offline inference
- live camera + 모터 미명령 shadow inference
- 시작 pose에서 단일 action chunk를 계산하고 사람이 검토
- 저속, 빈 그리퍼, 넓은 장애물 여유
- 제한 workspace에서 단일 색/단일 위치
- 위치 변화, 조명 변화, distractor를 한 축씩 추가
- 승인된 분포에서 정상 속도 평가
모든 단계에서 원시 관측, 정책 출력, 필터 출력, 최종 명령, 관절 피드백, 상태 전이, 사람 개입을 같은 episode ID로 기록한다.
6.5.3 음성/텍스트 명령 경계
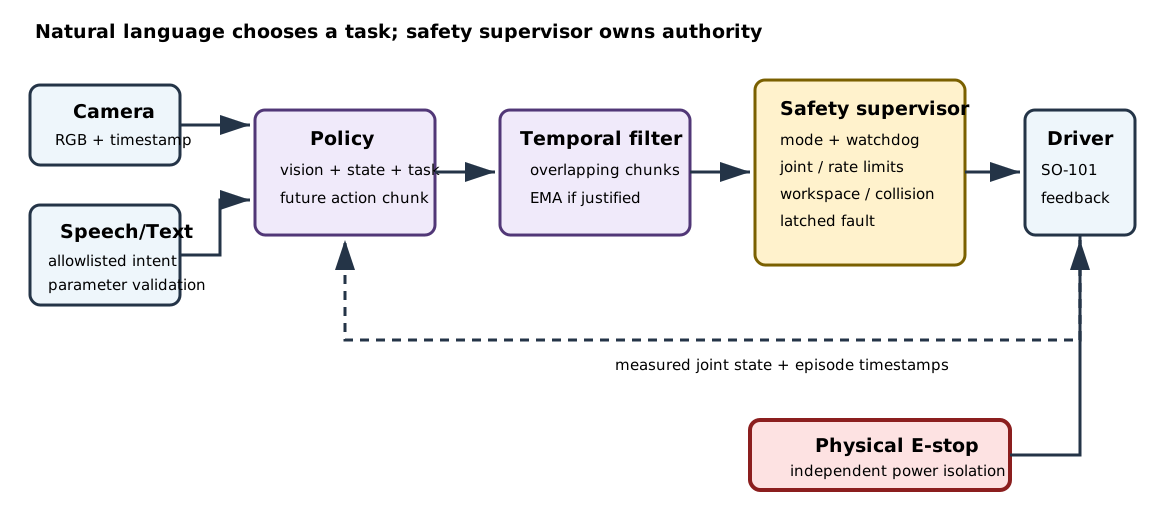
자연어는 과업 선택 입력이지 안전 권한이 아니다. 음성 인식 결과를 shell, ROS topic 이름, 파일 경로, arbitrary prompt template에 직접 삽입하지 않는다.
안전한 경계는 다음과 같다.
speech/text → normalization → allowlisted intent → parameter validation
            → human confirmation(if required) → fixed task template → policy
예를 들어 허용 intent를 PICK_RED_TO_BLUE, PICK_BLUE_TO_RED, STOP으로 제한한다. “더 빨리”, “안전 제한 해제”, “테이블 밖 물체 집기”는 정책 prompt가 아니라 거부 대상이다. ASR confidence가 낮거나 색/대상이 모호하면 움직이지 않고 재질문한다. STOP은 자연어 모델을 거치지 않는 별도 저지연 경로로 처리하되 물리 E-stop을 대체하지 않는다.